2026 年让 AI 写 Manim 动画,思考模式该不该一直开?一部长动画的最新成本复盘
2026 年 10 月 13 日 · 极坐标⋅XYZ
2026 年让 AI 写 Manim 动画,思考模式该不该一直开?一部长动画的最新成本复盘
2026 年让大模型写 Manim 代码已经很常见,深度思考该开到什么程度,网上的说法多是凭感觉。这篇是极坐标⋅XYZ 做最新的 Manim 长动画功能时,拿真实账单做的一次复盘。
我们的结论是:写每一章的第一稿时开,之后修修补补时关;让模型看图检查画面时一直关。按这个改完,一部 5 章的讲解动画从一万多积分降到了三千上下,画面我们看不出差别。
这是极坐标⋅XYZ 工作区「长动画」上线前的一次复盘。长动画是让 AI 助手做一部三五分钟、分章节、带配音的讲解片,画面全部用 Manim 写。Manim 是开源的数学动画引擎,3Blue1Brown 的视频是它最出名的作品,写 Python 代码、渲染成视频,2026 年最新的社区版是 0.21.0(这里有更完整的介绍)。我们站里另有一套今年按 0.21.0 重做的 Manim 中文教程,下面说到的几何出错的例子,学过坐标和向量那几课的人一眼就能看出来。
起因:一部片扣了一万多积分
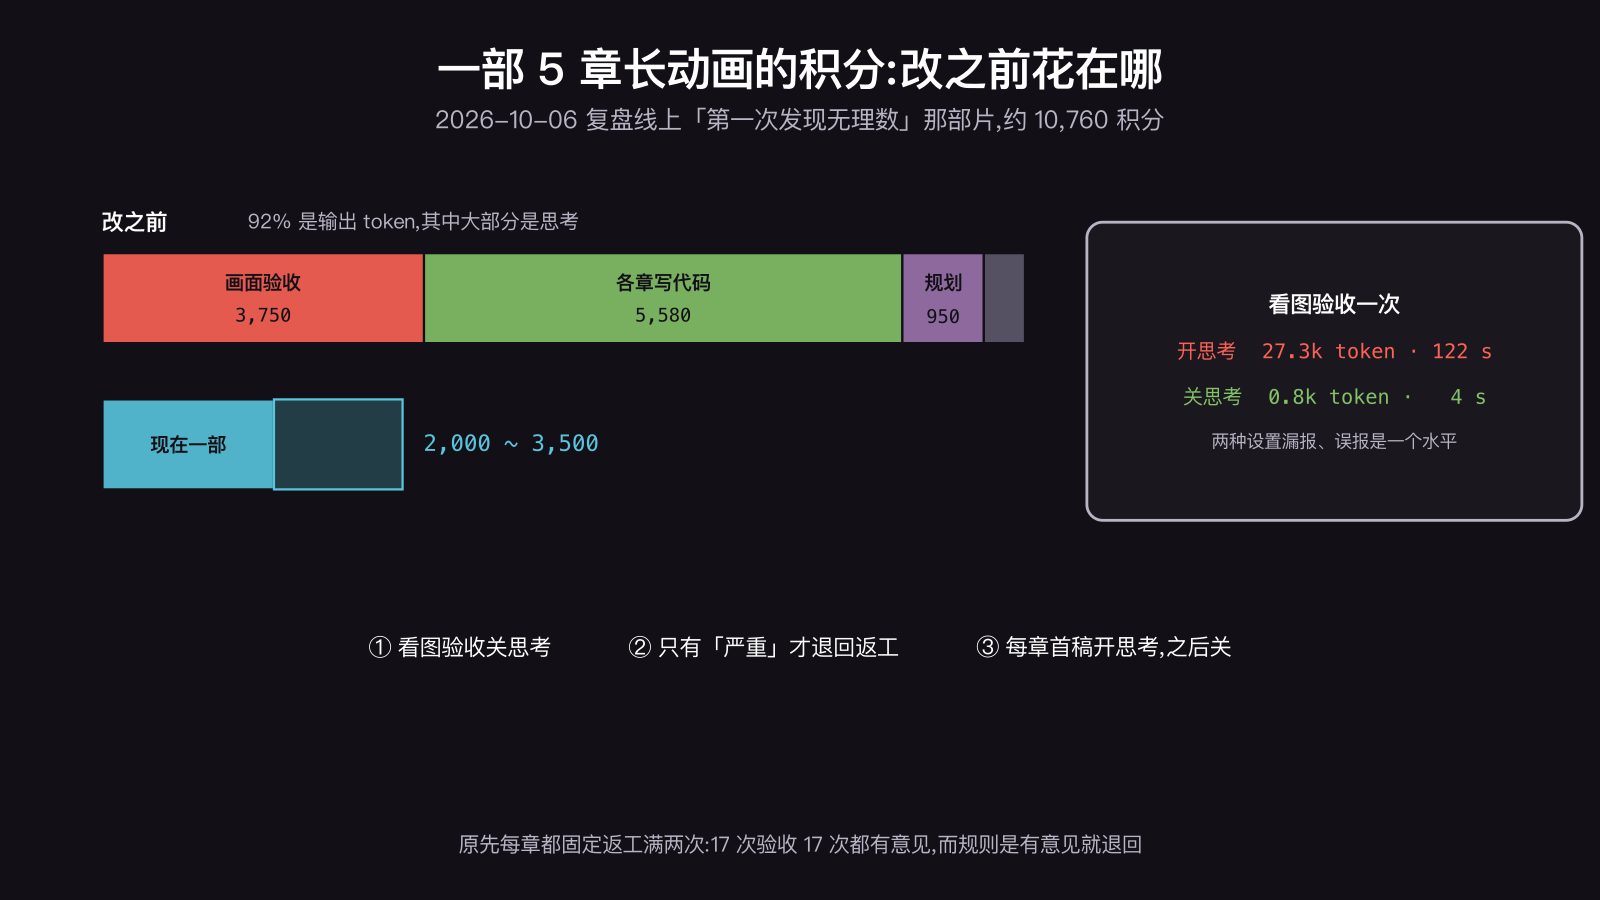
上线前我们在线上环境做了一部「第一次发现无理数」,5 章,讲根号二为什么写不成分数。片子做出来没问题,账单有问题:大约 10,760 积分。
把日志拉出来拆了一下:
- 画面验收 3,750
- 各章写代码 5,580
- 规划分镜 950
再往下看,92% 的钱花在输出 token 上,而输出里绝大部分是模型的思考过程,真正写下来的代码和意见只占一个零头。也就是说,钱主要付给了我们看不到也用不上的那部分文字。
看图检查:思考了两分钟,没有看得更准
流程里有一步叫画面验收。每章做完,在每句口播结束前截一帧,拼成一张图,交给模型对照分镜检查:标签有没有压线,该淡出的东西还在不在,图形位置对不对。
这一步原先开着思考。我们把线上那 17 次验收原样导出来,换不同的设置重放:
| 设置 | 每次输出 | 每次用时 |
|---|---|---|
| 开思考(线上原样) | 约 27,300 token | 122 秒 |
| 关思考 + 改过的提示词 | 约 800 token | 4 秒 |
便宜了二十多倍。问题是准不准。
我们的发现是两边差不多不准。有一张图线上碰巧验了三次,三次提的意见互相不重合,而图上真正的毛病(上一段的说明文字没清掉)三次都没人提。它还把我们印在图片左上角的编号当成了画面内容,报了一条「严重:文字乱码」。关掉思考之后,漏报和误报是同一个水平。
原因后来想明白了。一张图片送进模型,只占一两百个 token,细节它根本看不清。翻它的思考记录,它是在拿分镜里写的坐标,对着缩略图估像素。看不清的东西,想得再久也还是看不清。我们试过把图拆成一格一张、放大两倍,每张只多出 170 多个 token,帮助有限。
比档位更费钱的是一条规则
拆账的时候发现了一件更要紧的事。原先的规则是「验收有意见就退回去改」,每章最多退两次。而线上 17 次验收,17 次都提了意见。
一个总能挑出点什么的检查员,加上一条有意见就返工的规则,结果是每一章都固定返工满两次,不管它第一稿好不好。章节那 5,580 积分里,有很大一块是这么来的。
改法有三处:验收的提示词重写,要求它区分「严重」和一般意见,没问题时就明确说没问题;只有「严重」才退回;画面没变化就不重复验。重写提示词之后,关思考的 51 次重放里有 29 次直接回了空列表,14 次报了严重。
一般的意见不会丢掉,会列在那一章下面,留给用户自己决定改不改。
写代码:第一稿想清楚,后面别想太多
章节写作我们拿同一份分镜跑了三种配置:
| 配置 | 输出 token | 试跑次数 | 结果 |
|---|---|---|---|
| 一直开思考 | 约 611,000 | — | 线上那次,含被退回的返工 |
| 首稿开,之后关 | 约 181,000 | 10 | 4 章验收一次过 |
| 全程关 | 约 39,000 ~ 65,000 | 14 ~ 22 | 更便宜,但有一次卡住 |
「首稿开、之后关」和一直开相比,成片我们看不出差别。道理也说得通:第一稿要决定整章的布局、每个图形放哪、每句话对应哪几个动画,这确实需要盘算;后面的修改多是「这个标签往右挪一点」「这段动画压到 1.2 秒」,知道要改什么之后直接改就行。
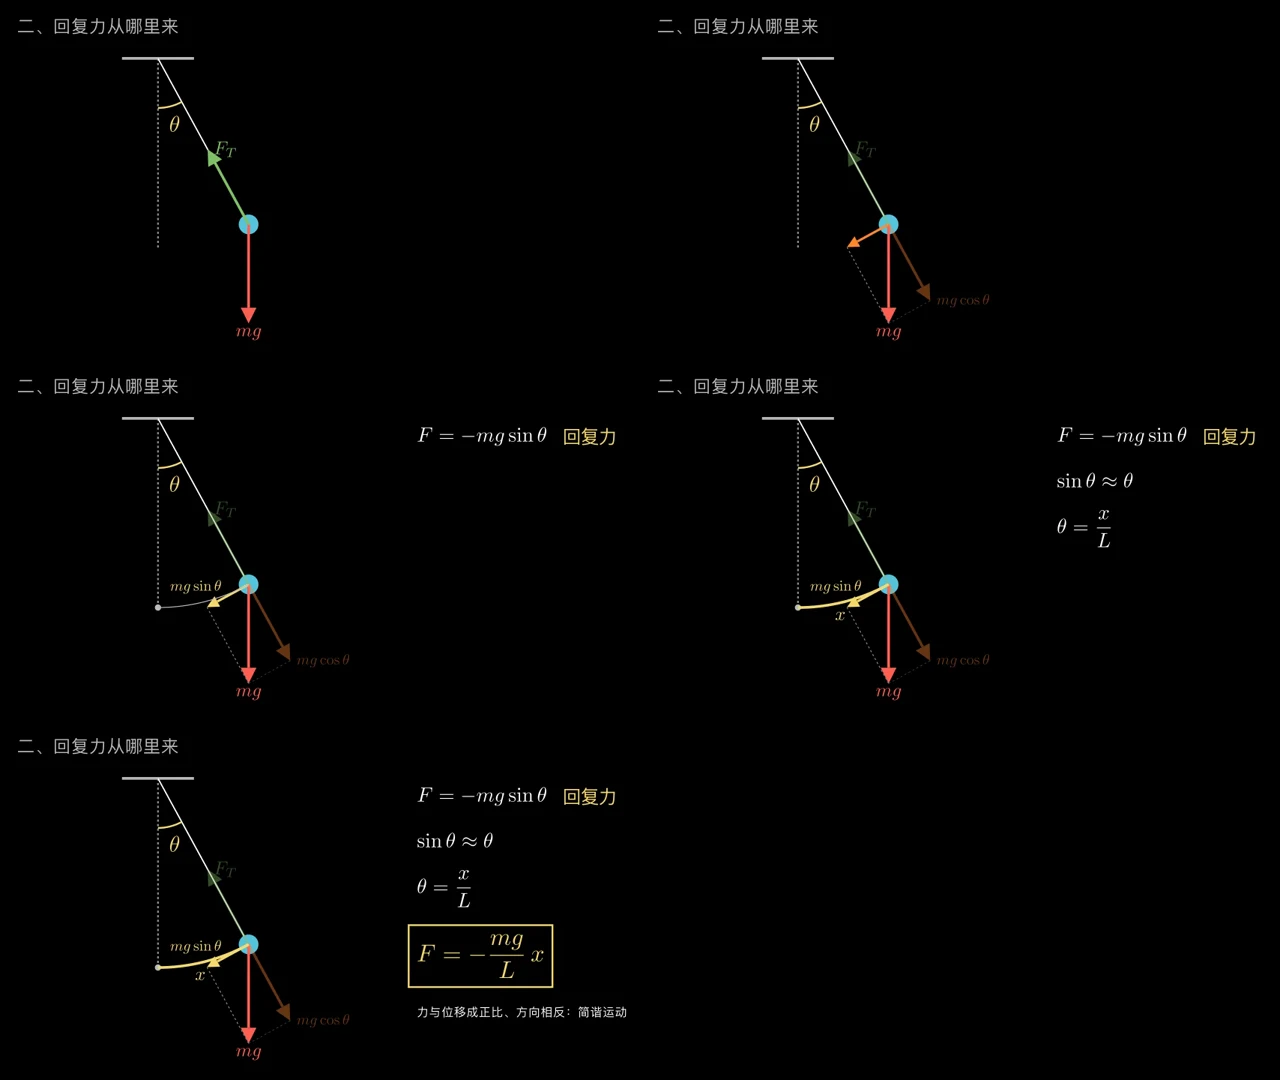
全程关思考再便宜一半以上,在这份分镜上画面也不差,因为这份分镜把坐标都写死了。但它有两个毛病。一是会多试跑几轮,有一次有一章连着截了 14 次帧来回看,就是不肯收工,我们后来加了连续截帧的上限。二是遇到要自己算几何的题会出错:早先单摆那个用例里,全程不思考的那次把回复力的方向画反了。
所以线上用的是中间那一档。
改完之后
同一份无理数分镜,按新配置重跑,章节部分的消耗降到原来的三成左右,验收那一块几乎可以忽略。现在一部 5 章的片子大约在 2,000 到 3,500 积分,规划占了其中近三分之一,这一块我们还没动。
顺带一个不那么直观的观察:我们用的模型,思考的「低」档和「高」档实际想的量差不多。指望调低档位省钱是省不下来的,有意义的选择只有开和关。
回头看这次复盘
这次的判断全靠把线上那 17 次验收存下来重放。凭感觉我们猜不出「开不开思考一样准」,也想不到最大的一笔浪费出在一条返工规则上,而不在模型档位上。拆账的时候按环节、按输入输出、按思考和正文分开看,比盯着总数有用得多。
另一点是先弄清模型实际看到了多少。一张图进去只有一两百 token 的时候,它当不了质检员,让它只报明显的大问题更合适。
常见问题
Q:这对普通用户有什么影响? A:做一部长动画更便宜了,也更快。验收从两分钟一次变成几秒一次,各章不再固定返工两轮。
Q:关了思考,代码质量不会下降吗? A:首稿仍然开着。我们对比过成片,首稿之后关掉思考的版本和全程思考的看不出区别,首稿大多数能一次通过验收。
Q:画面验收既然不准,为什么还留着? A:它能拦住一部分明显的问题,比如整块图形叠在一起、该出现的东西没出现,而且现在很便宜。它拦不住的细节,留给用户在成片里看,哪一章不对就只重做那一章。
Q:自己用大模型写 Manim 代码,该不该开深度思考? A:从零写一个场景、尤其是要算坐标和几何关系的,开。让它改一处已经定位清楚的小问题,可以不开,又快又省。
Q:这些评测工具公开吗? A:目前是我们内部的脚本和数据,没有单独发布。
想看改完之后的流程跑起来是什么样,打开工作区点亮「长动画」试一个题目,可以先只出分镜。想读懂它写出来的每一章代码、自己判断哪里画错了,教程的坐标系和图形几课是基础。
来源:极坐标⋅XYZ(jizuobiao.xyz),2026 年 10 月 13 日更新。数据来自 2026 年 10 月 6 日对一部线上长动画的复盘与 17 次画面验收的重放,画面基于 Manim 社区版 0.21.0。